
Gobernanza de IA


Representa el marco centralizado de políticas y reglas obligatorias que regulan el uso, comportamiento, seguridad y consumo de inteligencia artificial dentro de las aplicaciones. A través de estas políticas, los modeladores y administradores pueden establecer límites claros y controles normativos aplicables a todos los agentes integrados en una aplicación.
Definición y Principio de Precedencia
La política de gobernanza de IA se empaqueta como un elemento embebido de la aplicación. Su propósito principal es expresar normas de gobierno y restricciones obligatorias que garantizan el cumplimiento regulatorio, operativo y de seguridad.
Para asegurar que ningún ajuste individual flexibilice las reglas generales, se aplica un principio de precedencia jerárquico:
Política de Gobierno → Agente → Invocación del Agente → Usuario
Bajo este principio, una configuración o instrucción de menor jerarquía únicamente puede ser más restrictiva, pero nunca ampliar permisos ni omitir límites dictados por la política de gobierno.
Secciones de Configuración
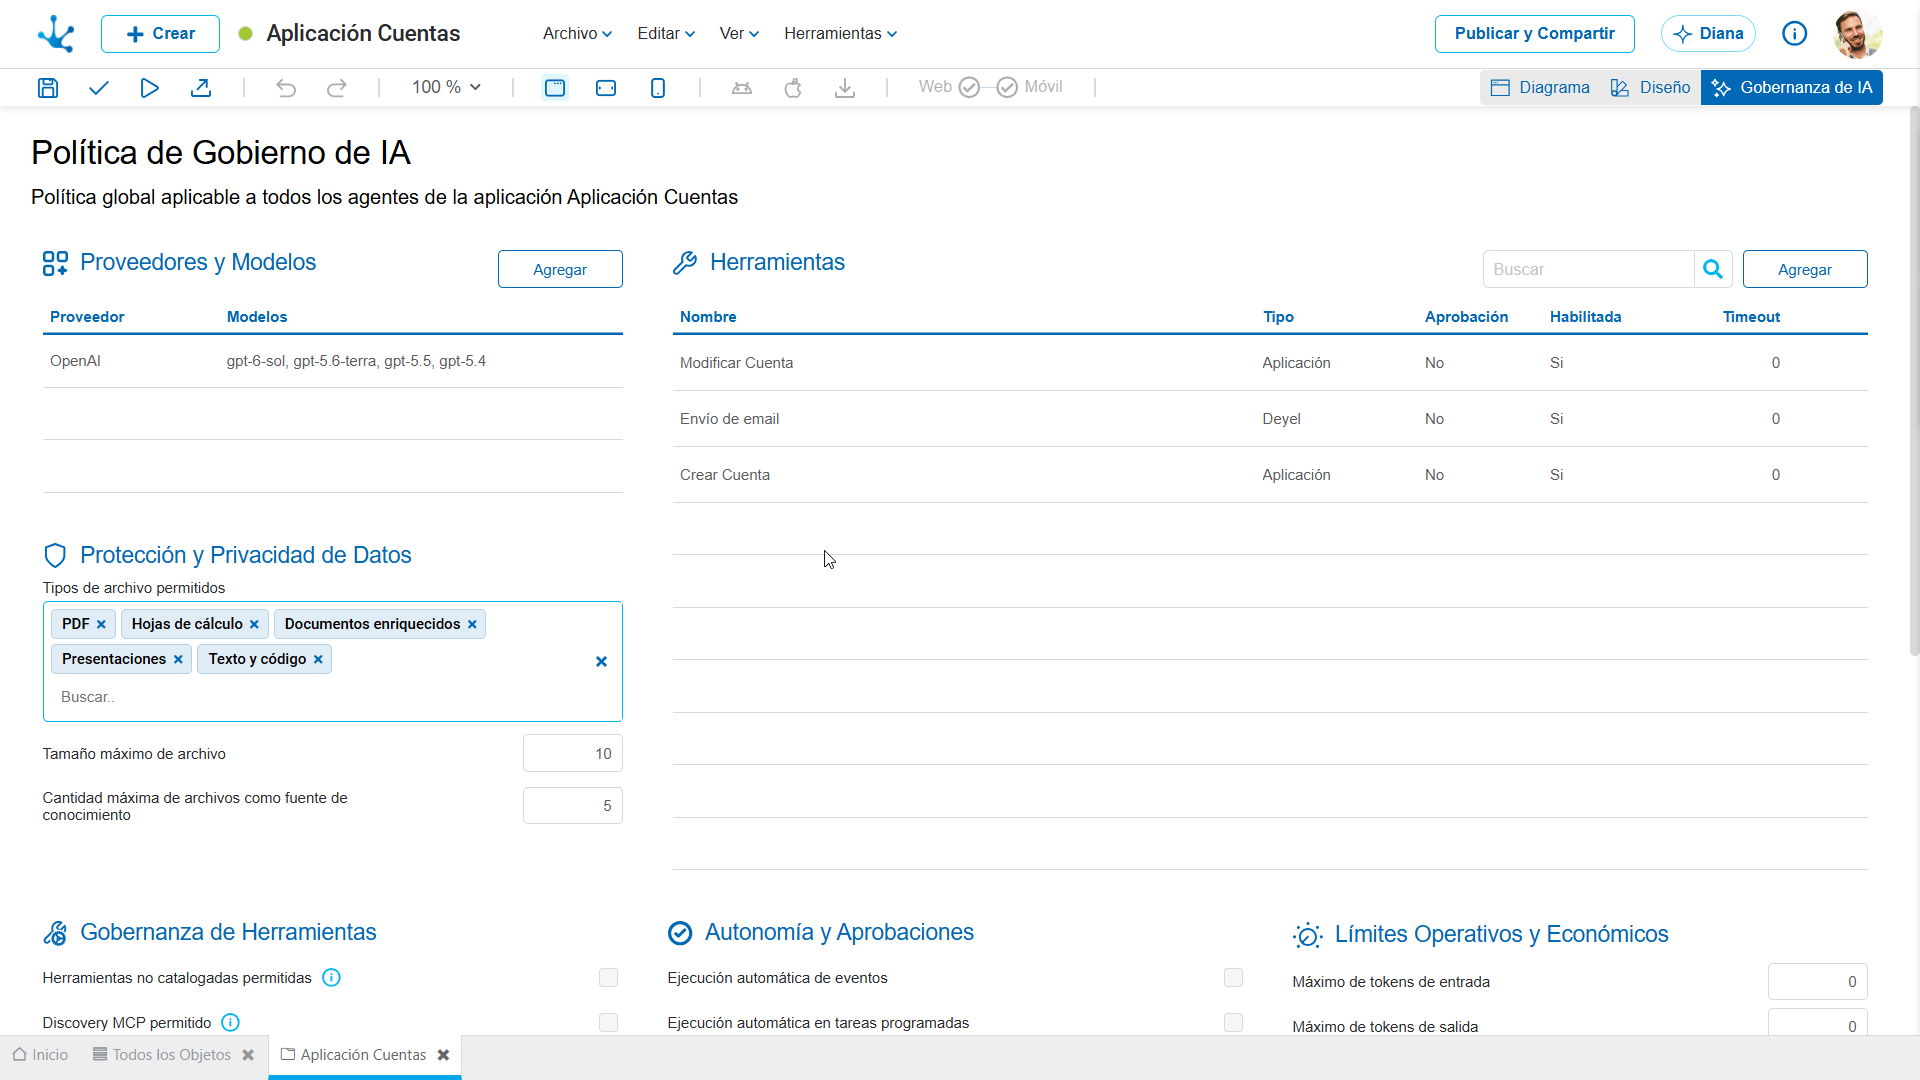
El panel de Gobernanza de IA se divide en áreas clave que regulan todos los aspectos operativos y de seguridad:
•Identificación
Permite registrar el nombre descriptivo y la explicación detallada del propósito y alcance organizacional de la política de gobierno.
•Proveedores y Modelos
Define una lista blanca de proveedores de IA autorizados (como OpenAI, Gemini, Azure OpenAI, entre otros) y especifica los modelos o versiones permitidos para evitar el uso de modelos no testeados o de alto costo.
•Herramientas
Permite definir y administrar la lista blanca de capacidades y funciones que los agentes pueden invocar para interactuar con el entorno y ejecutar acciones. En esta sección se catalogan y seleccionan las herramientas agrupadas por su origen o tipo:
•Herramientas de Aplicaciones: Funcionalidades u objetos de negocio específicos modelados dentro de las aplicaciones (entidades, procesos, reglas de negocio).
•Herramientas Deyel: Capacidades nativas e infraestructura general provistas por la plataforma Deyel para la manipulación y gestión de operaciones.
•Herramientas Nativas del LLM: Capacidades provistas directamente por el motor del proveedor de IA (por ejemplo, búsqueda web, ejecución de código o análisis interpretativo).
•Protección y Privacidad de Datos
Establece los criterios de seguridad para el manejo de información sensible y documentos utilizados como conocimiento, determinando los formatos permitidos (PDF, hojas de cálculo, documentos enriquecidos, etc.), el tamaño máximo de archivo y la cantidad límite de documentos procesables.
•Gobernanza de Herramientas
Define el marco estricto de seguridad, control y supervisión sobre la forma en que los agentes pueden descubrir, invocar y ejecutar herramientas externas e internas. Establece las políticas globales sobre el uso de funciones no catalogadas, el descubrimiento dinámico de capacidades y la ejecución coordinada o encadenada de acciones. Asimismo, incorpora mecanismos de control técnico para validar los parámetros antes de la invocación y limpiar las respuestas obtenidas, garantizando la integridad de los datos y previniendo vulnerabilidades operativas en la ejecución.
•Autonomía y Aprobaciones
Fija los niveles de independencia del agente (ejecución autónoma en eventos, tareas programadas o procesos) y establece los mecanismos de supervisión humana (Human-in-the-Loop). Incluye controles de vigencia, revocación ante cambio de contexto y modalidades de confirmación estructurada o aprobaciones vía chat.
•Límites Operativos y Económicos
Establece techos de consumo para prevenir costos excesivos o bucles infinitos. Controla el tope de tokens de entrada y salida, límite diario de tokens, máximo de invocaciones a herramientas, tiempos de espera (timeouts), concurrencia y límites de tasa (rate limits) por agente o usuario.
•Auditoría y Observabilidad
Establece el nivel de profundidad e información detallada que se conserva para supervisar las interacciones de la inteligencia artificial.
•Memoria y Conversaciones
Gestiona el tratamiento del historial conversacional entre el usuario y el agente, permitiendo configurar umbrales de procesamiento para mantener el contexto óptimo dentro de las restricciones de tokens del modelo.